
Le guide complet de l'agrandissement d'image par IA : comment il fonctionne et quand l'utiliser
Tous les upscalers d'image affrontent le même problème : ils doivent produire des pixels qui n'existent pas dans l'original. Une photo de 1000 pixels de large agrandie à 4000 pixels contient seize fois plus de pixels, et quinze sur seize doivent être créés. La façon dont un outil les crée fait toute la différence entre un agrandissement mou et flou et un agrandissement net. Cet article explique, étape par étape, comment procèdent les méthodes classiques, comment procède la super-résolution par IA, comment un upscaler dans le navigateur comme le nôtre fait tourner un réseau de neurones sur votre carte graphique, et comment mesurer le résultat plutôt que croire qui que ce soit sur parole.
Le redimensionnement classique : faire la moyenne des voisins
Avant les réseaux de neurones, tout agrandissement était une forme d'interpolation : estimer chaque nouveau pixel à partir des pixels d'origine qui l'entourent.
- Le plus proche voisin copie le pixel d'origine le plus proche. Rapide, et il garde les contours francs, mais tout se transforme en carrés visibles. Le pixel art est agrandi ainsi exprès.
- Le bilinéaire mélange les quatre pixels les plus proches. Doux, mais mou.
- Le bicubique utilise seize pixels voisins avec une courbe qui préserve un peu plus de contraste sur les contours. C'est ce qu'utilisent par défaut la plupart des logiciels et navigateurs pour un redimensionnement « haute qualité ».
- Lanczos utilise une fenêtre plus large et garde des contours encore un peu plus nets, au prix de légères ondulations près des contours marqués.
Toutes ces méthodes ont une limite commune : elles ne regardent que des nombres, pas ce que ces nombres représentent. Un contour entre un cil sombre et une peau claire n'est, pour l'interpolation bicubique, qu'un brusque changement de valeurs, et le mieux qu'elle puisse faire est de tracer une pente douce à travers l'écart. Cette pente, c'est le flou que l'on voit sur toute photo agrandie. Aucun réglage ne le corrige, car l'information nécessaire pour tracer un contour net au bon endroit n'est pas dans les pixels voisins.
La super-résolution : apprendre à quoi ressemble le détail
L'agrandissement par IA, appelé techniquement super-résolution à image unique, procède autrement. Au lieu d'une formule fixe, il utilise un réseau de neurones qui a appris, à partir de nombreuses images d'exemple, à quoi ressemble habituellement le détail fin pour une image basse résolution donnée.
L'entraînement est simple dans son principe. Les chercheurs prennent une grande collection de photos haute résolution, réduisent chacune d'elles et demandent au réseau de reproduire l'original à partir de la petite version. Chaque fois qu'il se trompe, ses paramètres internes sont légèrement ajustés vers une meilleure réponse. Après des millions d'exemples, le réseau a assimilé des motifs : comment les contours se prolongent, à quoi ressemblent de près les cheveux, le feuillage et le texte, comment une marche floue entre deux couleurs se résout généralement en une limite nette.
Quelques étapes marquantes de cette recherche :
- SRCNN (2014) a montré qu'un petit réseau convolutif pouvait nettement battre l'interpolation bicubique sur les bancs d'essai courants.
- ESRGAN (2018) a ajouté un second réseau pendant l'entraînement, un « discriminateur » qui essaie de distinguer les vraies photos des photos agrandies. L'upscaler est récompensé quand il le trompe, ce qui pousse les résultats vers une texture réaliste plutôt que vers une moyenne lisse et prudente.
- Real-ESRGAN (2021) a été entraîné sur des images dégradées de nombreuses façons réalistes à la fois (flou, bruit, compression JPEG, redimensionnements répétés), ce qui lui permet de mieux gérer les photos du monde réel que des images propres réduites artificiellement. C'est la famille de modèles utilisée par des applications de bureau comme Upscayl.
L'idée du discriminateur explique à la fois la force et la principale bizarrerie des upscalers modernes. Ils produisent une texture crédible, parce qu'ils ont été entraînés pour ça. Mais crédible ne veut pas dire vrai. Quand l'image de départ ne contient pas assez d'information, le réseau comble le vide avec ce que contiennent habituellement des images similaires : une peau plausible, un tissu plausible, des feuilles plausibles.
Ce que signifient les modèles « 2x » et « 4x »
Un réseau de super-résolution est en général entraîné pour un facteur fixe. Un modèle 4x produit toujours quatre fois la largeur et la hauteur de l'entrée ; un modèle 2x, le double. Pour obtenir une autre taille, les outils utilisent le modèle le plus proche puis redimensionnent le résultat. C'est pour cela que notre upscaler propose exactement 2x et 4x : chaque option correspond à un passage d'un modèle adapté (ESRGAN-slim 2x ou 4x), et tout petit ajustement pour atteindre une taille exacte est un simple redimensionnement fait ensuite.
C'est aussi pour cela que repasser un résultat 4x dans un modèle 4x aide rarement. Le second passage traite la texture inventée par le premier comme si elle était réelle et en invente davantage par-dessus.
Faire tourner un réseau de neurones dans un navigateur
Les upscalers côté serveur font tourner leurs modèles sur des cartes graphiques dédiées. Un upscaler dans le navigateur doit fonctionner sur l'ordinateur du visiteur, quel qu'il soit, via les standards du web. Le nôtre repose sur trois éléments :
- Le modèle : ESRGAN-slim, une version compacte d'ESRGAN distribuée via la bibliothèque UpscalerJS, assez petite pour être téléchargée une fois et gardée dans le cache du navigateur.
- Le moteur : TensorFlow.js, qui exécute les calculs du réseau sur la carte graphique grâce à WebGL.
- Le découpage en tuiles : l'image est découpée en morceaux de 128 × 128 pixels qui se chevauchent de quelques pixels, chaque morceau est agrandi séparément, puis les résultats sont recousus. Cela garde l'usage de la mémoire graphique assez bas pour un portable ordinaire, et le chevauchement évite les coutures visibles.
Le découpage explique que le temps de traitement augmente avec la taille de l'image de départ plutôt qu'avec le facteur. Dans nos tests, une image de 480 pixels a pris de 3 à 6 secondes en 4x une fois le modèle chargé, alors qu'une photo de 1,7 mégapixel a pris environ 20 secondes en 2x. Le premier passage d'une session est plus lent, car le modèle doit être téléchargé et « préchauffé ».
Le navigateur impose des limites qu'une application de bureau n'a pas. Les navigateurs mobiles ne laissent pas assez de mémoire graphique aux pages web pour le modèle, donc sur téléphone et tablette notre outil utilise un moteur classique (un redimensionnement haute qualité par étapes, plus les curseurs d'amélioration). Sur ordinateur, l'IA accepte les images jusqu'à environ 10 mégapixels, et l'outil est conçu pour des résultats jusqu'en 4K, une taille que les navigateurs gèrent sans difficulté sur un ordinateur ordinaire.
Mesurer la différence
Dire « plus net », c'est facile. Nous l'avons mesuré. Nous avons pris un portrait, l'avons réduit à 480 × 480 pixels pour simuler une vieille photo basse résolution, puis l'avons agrandi en 4x jusqu'à 1920 × 1920 de deux façons : avec le redimensionnement haute qualité du navigateur lui-même, et avec le modèle d'IA. Nous avons ensuite mesuré le détail des contours sur le même recadrage de 480 × 480 du visage dans les deux cas, à l'aide de la variance du laplacien (une mesure courante de la quantité de contraste fin sur les contours d'une image).
Le redimensionnement classique a obtenu 3,0. Le résultat IA a obtenu 34,7, soit environ onze fois plus de détail sur les contours. Regarder les images explique le chiffre : les cils redevenaient des brins séparés, les bords des dents étaient propres et la naissance des cheveux avait de la texture au lieu d'une tache molle. Cela montrait aussi la bizarrerie : la peau était plus lisse que sur une vraie photo haute résolution, un peu comme après une retouche légère.
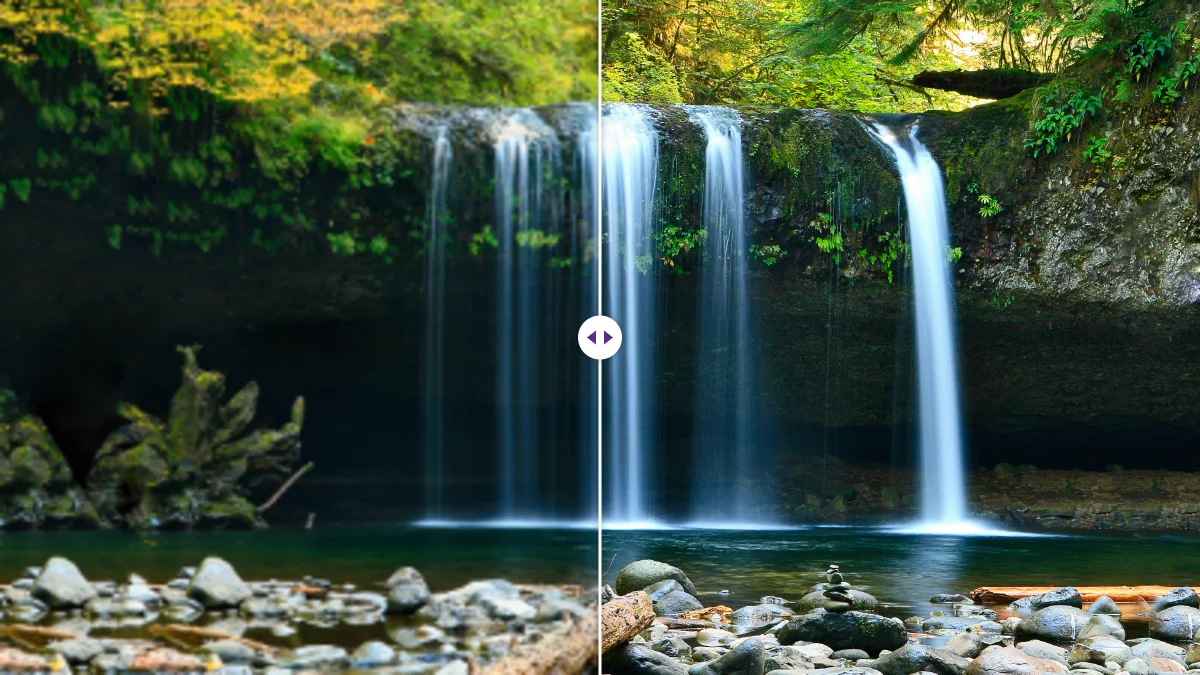
Un mot sur la mesure. Les articles de recherche donnent souvent le PSNR, un chiffre qui récompense la proximité avec l'original pixel par pixel. Les modèles entraînés avec un discriminateur obtiennent en général un PSNR un peu plus bas que des modèles plus lisses, tout en paraissant meilleurs aux yeux des gens, car une texture réaliste légèrement mal placée coûte plus de points qu'un flou prudent. C'est pourquoi nous avons regardé le détail des contours et les images elles-mêmes plutôt qu'un seul chiffre de référence.
Pourquoi les résultats varient autant d'une photo à l'autre
- Le contenu que le modèle connaît bien (visages, cheveux, texte, objets courants, textures naturelles) ressort le mieux.
- Les dégâts de compression le trompent : les blocs JPEG sont aussi du « détail » et peuvent être agrandis comme tel. Partir de la copie la plus propre compte plus que n'importe quel réglage.
- Le flou n'est pas un manque de résolution, c'est un manque d'information. Une photo floue agrandie est une photo floue plus grande.
- Les sujets minuscules donnent trop peu de matière au modèle, donc ce qu'il produit est surtout sa propre supposition.
- La transparence demande un traitement spécial, car le modèle ne voit que la couleur. En testant, nous avons découvert que notre upscaler rendait noirs les fonds transparents ; il remplit désormais la zone vide avec les couleurs de bord les plus proches avant d'agrandir, puis restaure la transparence d'origine.
Pourquoi l'œil s'y laisse prendre
Un dernier point sur la raison pour laquelle tout cela fonctionne. Nos yeux jugent la netteté surtout aux contours : les limites entre clair et sombre. Une image aux contours nets et à la texture simplifiée paraît nette ; une image à la texture exacte et aux contours mous paraît floue. Les modèles de super-résolution exploitent ce fait. Ils concentrent leurs efforts là où nous regardons, et c'est pourquoi un résultat IA peut paraître plus net que ne le justifie strictement l'information qu'il contient.
Mettre tout ça en pratique
Savoir comment ça marche mène à quelques habitudes pratiques. Donnez au modèle l'original le plus propre et le plus grand possible. Choisissez le facteur qui atteint la taille voulue, car chaque doublement supplémentaire, c'est plus d'invention, pas plus de vérité. Laissez la netteté à zéro au début, car le modèle reconstruit déjà les contours. Vérifiez les résultats à 100 % sur les parties qui comptent. Et enregistrez les photos en JPG ou WebP ; dans nos tests, un résultat en 2x pesait 6,85 Mo en PNG et 337 Ko en WebP, sans différence visible.
Pour des besoins précis, les guides vont plus loin : comment augmenter la résolution d'une image pour l'impression, comment agrandir une image en 4K pour les écrans, et les différences entre agrandir et améliorer. Si vous voulez essayer, l'upscaler d'image fonctionne entièrement dans votre navigateur ; votre photo n'est envoyée nulle part.
Questions fréquentes
Pourquoi un redimensionnement classique rend-il les images floues ?
L'interpolation estime chaque nouveau pixel à partir de ses voisins : un contour net devient une pente douce entre deux valeurs. L'information pour tracer un contour net n'est pas dans les pixels voisins.
L'agrandissement par IA, est-ce du vrai détail ?
C'est une estimation apprise. Les contours et les formes sont reconstruits de façon convaincante, tandis que la texture fine et aléatoire, comme les pores ou le gravier, est inventée pour paraître plausible plutôt que retrouvée.
Pourquoi l'upscaler dans le navigateur travaille-t-il par tuiles ?
Il traite l'image par morceaux de 128 × 128 pixels qui se chevauchent légèrement, pour qu'un portable ordinaire ait assez de mémoire graphique ; le chevauchement évite les coutures visibles.
À lire aussi
Des outils d'image gratuits, directement dans votre navigateur
Agrandir, supprimer un fond, effacer les métadonnées, recadrer, compresser ou créer un QR code. Sans envoi, sans inscription, sans filigrane.