
Guia completo de ampliação de imagens com IA: como funciona e quando você precisa
Todo upscaler de imagem enfrenta o mesmo problema: precisa produzir pixels que não estão no original. Uma foto de 1000 pixels de largura ampliada para 4000 tem dezesseis vezes mais pixels, e quinze de cada dezesseis precisam ser criados. O jeito como uma ferramenta cria esses pixels é toda a diferença entre uma ampliação mole e borrada e uma que parece nítida. Este texto explica, passo a passo, como os métodos clássicos fazem isso, como a super-resolução com IA faz, como um upscaler no navegador como o nosso roda uma rede neural na sua placa de vídeo e como medir o resultado em vez de acreditar na palavra de alguém.
O redimensionamento clássico: a média dos vizinhos
Antes das redes neurais, toda ampliação era uma forma de interpolação: estimar cada pixel novo a partir dos pixels originais em volta.
- Vizinho mais próximo copia o pixel original mais perto. É rápido e mantém as bordas duras, mas tudo vira quadradinhos visíveis. Pixel art é ampliada assim de propósito.
- Bilinear mistura os quatro pixels mais próximos. Suave, mas mole.
- Bicúbico usa dezesseis pixels em volta com uma curva que preserva um pouco mais de contraste nas bordas. É o que a maioria dos editores e navegadores usa por padrão para o redimensionamento de "alta qualidade".
- Lanczos usa uma janela mais larga e mantém as bordas ainda um pouco mais nítidas, ao custo de leves ondulações perto de bordas fortes.
Todos têm uma limitação em comum: só olham números, não o que os números representam. Uma borda entre um cílio escuro e a pele clara é, para a interpolação bicúbica, só uma mudança brusca de valores, e o melhor que ela consegue é desenhar uma rampa suave atravessando o salto. Essa rampa é o borrão que você vê em toda foto ampliada. Nenhum ajuste resolve, porque a informação necessária para desenhar uma borda nítida no lugar certo não está nos pixels vizinhos.
Super-resolução: aprender como é o detalhe
A ampliação com IA, chamada tecnicamente de super-resolução de imagem única, segue outro caminho. Em vez de uma fórmula fixa, ela usa uma rede neural que aprendeu, com muitas imagens de exemplo, como o detalhe fino costuma ser a partir de uma imagem de baixa resolução.
O treinamento é simples na ideia. Pesquisadores pegam uma grande coleção de fotos em alta resolução, reduzem cada uma e pedem à rede que reproduza o original a partir da versão pequena. Cada vez que ela erra, seus parâmetros internos são ajustados um pouco na direção de uma resposta melhor. Depois de milhões de exemplos, a rede absorveu padrões: como as bordas continuam, como cabelo, folhagem e texto são de perto, como um degrau borrado entre duas cores normalmente se resolve num limite nítido.
Alguns marcos dessa linha de pesquisa:
- SRCNN (2014) mostrou que uma rede convolucional pequena conseguia superar com folga a interpolação bicúbica nos testes de referência comuns.
- ESRGAN (2018) acrescentou uma segunda rede no treinamento, um "discriminador" que tenta diferenciar fotos reais de fotos ampliadas. O upscaler é recompensado quando o engana, o que empurra os resultados para uma textura realista em vez de uma média lisa e segura.
- Real-ESRGAN (2021) foi treinado com imagens degradadas de vários jeitos realistas ao mesmo tempo (borrão, ruído, compressão JPEG, redimensionamentos repetidos), então lida melhor com fotos do mundo real do que com imagens limpas reduzidas artificialmente. É a família de modelos usada por apps de desktop como o Upscayl.
A ideia do discriminador explica tanto a força quanto a principal peculiaridade dos upscalers modernos. Eles produzem textura convincente, porque foram treinados para isso. Mas convincente não é o mesmo que verdadeiro. Quando a imagem de entrada não tem informação suficiente, a rede preenche a lacuna com o que imagens parecidas costumam ter: pele plausível, tecido plausível, folhas plausíveis.
O que significam os modelos "2x" e "4x"
Uma rede de super-resolução costuma ser treinada para um fator fixo. Um modelo 4x sempre gera quatro vezes a largura e a altura da entrada; um modelo 2x, o dobro. Para chegar a outro tamanho, as ferramentas usam o modelo mais próximo e depois redimensionam o resultado. É por isso que o nosso upscaler oferece exatamente 2x e 4x: cada opção corresponde a uma passada de um modelo equivalente (ESRGAN-slim 2x ou 4x), e qualquer pequeno ajuste para bater um tamanho exato é um redimensionamento comum feito depois.
É também por isso que passar um resultado 4x de novo por um modelo 4x raramente ajuda. A segunda passada trata a textura inventada na primeira como se fosse real e inventa mais em cima dela.
Rodando uma rede neural no navegador
Upscalers em servidor rodam os modelos em placas de vídeo dedicadas. Um upscaler no navegador precisa rodar no computador que o visitante tiver, usando padrões da web. O nosso usa três peças:
- O modelo: ESRGAN-slim, uma versão compacta do ESRGAN distribuída pela biblioteca UpscalerJS, pequena o bastante para ser baixada uma vez e guardada no cache do navegador.
- O motor: TensorFlow.js, que roda os cálculos da rede na placa de vídeo via WebGL.
- Os blocos: a imagem é cortada em pedaços de 128 × 128 pixels com alguns pixels de sobreposição, cada pedaço é ampliado separadamente e os resultados são costurados de volta. Isso mantém o uso de memória gráfica baixo o suficiente para notebooks comuns, e a sobreposição evita emendas visíveis.
Os blocos explicam por que o tempo de processamento cresce com o tamanho da imagem de entrada e não com o fator. Nos nossos testes, uma imagem de 480 pixels levou de 3 a 6 segundos em 4x depois que o modelo carregou, enquanto uma foto de 1,7 megapixel levou cerca de 20 segundos em 2x. A primeira passada de cada sessão é mais lenta porque o modelo precisa ser baixado e "aquecido".
O navegador impõe limites que um app de desktop não tem. Os navegadores móveis não dão às páginas memória gráfica suficiente para o modelo, então em celulares e tablets a nossa ferramenta usa um motor clássico (redimensionamento de alta qualidade em etapas mais os controles de melhoria). Em computadores, a IA aceita imagens de até uns 10 megapixels, e a ferramenta foi feita para resultados de até 4K, um tamanho que os navegadores aguentam bem em computadores comuns.
Medindo a diferença
Dizer "mais nítido" é fácil. Nós medimos. Pegamos um retrato, reduzimos para 480 × 480 pixels para fazer de conta que era uma foto antiga de baixa resolução e ampliamos em 4x para 1920 × 1920 de dois jeitos: com o redimensionamento de alta qualidade do próprio navegador e com o modelo de IA. Depois medimos o detalhe das bordas no mesmo recorte de 480 × 480 do rosto nas duas versões, usando a variância do laplaciano (uma medida padrão de quanto contraste fino de borda uma imagem tem).
O redimensionamento comum marcou 3,0. O resultado com IA marcou 34,7, cerca de onze vezes mais detalhe nas bordas. Olhar as imagens explica o número: os cílios voltaram a ser fios separados, as bordas dos dentes estavam limpas e a linha do cabelo tinha textura em vez de uma mancha mole. Também apareceu a peculiaridade: a pele saiu mais lisa do que numa foto real de alta resolução, um pouco como depois de um retoque leve.
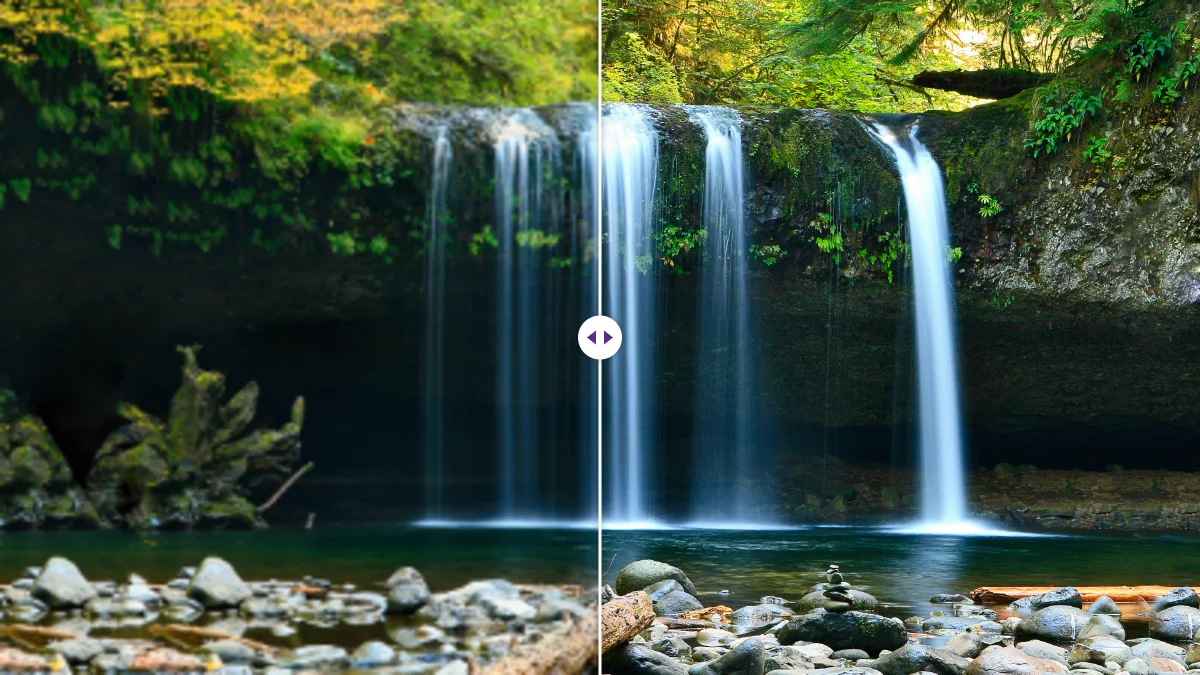
Uma observação sobre a medição. Artigos de pesquisa costumam informar o PSNR, um número que premia a proximidade com o original pixel a pixel. Modelos treinados com discriminador costumam marcar um pouco menos no PSNR do que modelos mais lisos, embora pareçam melhores para as pessoas, porque uma textura realista levemente fora do lugar custa mais pontos do que um borrão seguro. Por isso olhamos o detalhe das bordas e as próprias imagens, e não um único número de referência.
Por que os resultados variam tanto de uma foto para outra
- O conteúdo que o modelo conhece bem (rostos, cabelo, texto, objetos comuns, texturas naturais) sai melhor.
- Danos de compressão confundem o modelo: os blocos do JPEG também são "detalhe" e podem ser ampliados como tal. Começar pela cópia mais limpa importa mais do que qualquer ajuste.
- O borrão não é falta de resolução, é falta de informação. Uma foto fora de foco ampliada é uma foto fora de foco maior.
- Assuntos minúsculos dão ao modelo pouco demais com o que trabalhar, então o que ele produz é principalmente um palpite próprio.
- A transparência precisa de um tratamento especial, porque o modelo só enxerga cor. Nos testes, descobrimos que o nosso upscaler deixava os fundos transparentes pretos; agora ele preenche a área vazia com as cores de borda mais próximas antes de ampliar e restaura a transparência original depois.
Por que engana o olho
Um último ponto sobre por que isso funciona. Nossos olhos julgam a nitidez principalmente pelas bordas: os limites entre claro e escuro. Uma imagem com bordas nítidas e textura simplificada parece nítida; uma com textura exata e bordas moles parece borrada. Os modelos de super-resolução aproveitam isso. Eles concentram o esforço onde a gente olha, e é por isso que um resultado com IA pode parecer mais nítido do que a informação que ele contém justificaria a rigor.
Colocando em prática
Entender como funciona leva a alguns hábitos práticos. Dê ao modelo o original mais limpo e maior que houver. Escolha o fator que chega ao tamanho de que você precisa, porque cada dobra a mais é mais invenção, não mais verdade. Deixe a nitidez no zero no começo, porque o modelo já reconstrói as bordas. Confira os resultados em 100% nas partes que importam. E salve as fotos em JPG ou WebP; nos nossos testes, um resultado em 2x ficou com 6,85 MB em PNG e 337 KB em WebP, sem diferença visível.
Para trabalhos específicos, os guias vão além: como aumentar a resolução de uma imagem para impressão, como ampliar uma imagem para 4K para telas, e as diferenças entre ampliar e melhorar. Se quiser experimentar, o upscaler de imagem roda inteiro no seu navegador; sua foto não é enviada para lugar nenhum.
Perguntas frequentes
Por que um redimensionamento comum deixa a imagem borrada?
A interpolação estima cada pixel novo a partir dos vizinhos, então uma borda nítida vira uma rampa suave entre dois valores. A informação para desenhar a borda nítida não está nos pixels vizinhos.
A ampliação com IA é detalhe real?
É uma estimativa aprendida. Bordas e formas são reconstruídas de forma convincente, enquanto a textura fina e aleatória, como poros ou cascalho, é inventada para parecer plausível, e não recuperada.
Por que o upscaler no navegador trabalha em blocos?
Ele processa a imagem em pedaços de 128 × 128 pixels com uma pequena sobreposição, para que um notebook comum tenha memória gráfica suficiente; a sobreposição evita emendas visíveis.
Continue lendo
Ferramentas de imagem grátis, no seu navegador
Amplie, remova fundos, apague metadados, recorte, comprima ou crie um QR code. Sem upload, sem cadastro e sem marca d'água.