
Guida completa all'ingrandimento delle immagini con IA: come funziona e quando serve
Ogni upscaler di immagini affronta lo stesso problema: deve produrre pixel che nell'originale non ci sono. Una foto larga 1000 pixel ingrandita a 4000 ha sedici volte più pixel, e quindici su sedici vanno creati. Il modo in cui uno strumento li crea fa tutta la differenza tra un ingrandimento morbido e sfocato e uno che appare nitido. Questo articolo spiega, passo dopo passo, come fanno i metodi classici, come fa la super-risoluzione con IA, come un upscaler nel browser come il nostro esegue una rete neurale sulla tua scheda grafica e come misurare il risultato invece di fidarsi della parola di qualcuno.
Il ridimensionamento classico: la media dei vicini
Prima delle reti neurali, ogni ingrandimento era una forma di interpolazione: stimare ogni nuovo pixel a partire dai pixel originali intorno.
- Vicino più prossimo copia il pixel originale più vicino. Veloce, e mantiene i bordi netti, ma tutto diventa quadretti visibili. La pixel art si ingrandisce così di proposito.
- Bilineare mescola i quattro pixel più vicini. Morbido, ma poco definito.
- Bicubico usa sedici pixel circostanti con una curva che conserva un po' più di contrasto sui bordi. È quello che la maggior parte dei programmi e dei browser usa di default per il ridimensionamento "di alta qualità".
- Lanczos usa una finestra più ampia e mantiene i bordi ancora un po' più nitidi, al prezzo di leggere increspature accanto ai bordi forti.
Tutti hanno un limite in comune: guardano solo numeri, non ciò che i numeri rappresentano. Un bordo tra un ciglio scuro e una pelle chiara è, per l'interpolazione bicubica, solo un brusco cambio di valori, e il meglio che può fare è disegnare una rampa morbida attraverso il salto. Quella rampa è la sfocatura che vedi in ogni foto ingrandita. Nessuna regolazione la risolve, perché l'informazione necessaria per disegnare un bordo netto nel punto giusto non si trova nei pixel vicini.
La super-risoluzione: imparare com'è il dettaglio
L'ingrandimento con IA, chiamato tecnicamente super-risoluzione da immagine singola, segue un'altra strada. Invece di una formula fissa usa una rete neurale che ha imparato, da moltissime immagini di esempio, come appare di solito il dettaglio fine a partire da un'immagine a bassa risoluzione.
L'addestramento è semplice nel concetto. I ricercatori prendono una grande raccolta di foto ad alta risoluzione, le riducono e chiedono alla rete di ricostruire l'originale partendo dalla versione piccola. Ogni volta che sbaglia, i suoi parametri interni vengono spostati un po' verso una risposta migliore. Dopo milioni di esempi, la rete ha assorbito degli schemi: come proseguono i bordi, come appaiono da vicino capelli, fogliame e testo, come un gradino sfocato tra due colori di solito si risolve in un confine netto.
Alcune tappe di questa ricerca:
- SRCNN (2014) ha mostrato che una piccola rete convoluzionale poteva battere nettamente l'interpolazione bicubica nei test di riferimento comuni.
- ESRGAN (2018) ha aggiunto una seconda rete durante l'addestramento, un "discriminatore" che cerca di distinguere le foto vere da quelle ingrandite. L'upscaler viene premiato quando lo inganna, il che spinge i risultati verso una texture realistica invece che verso una media liscia e prudente.
- Real-ESRGAN (2021) è stato addestrato su immagini degradate in molti modi realistici insieme (sfocatura, rumore, compressione JPEG, ridimensionamenti ripetuti), così se la cava meglio con le foto reali che con immagini pulite ridotte artificialmente. È la famiglia di modelli usata da app desktop come Upscayl.
L'idea del discriminatore spiega sia la forza sia la principale stranezza degli upscaler moderni. Producono una texture credibile, perché sono stati addestrati a farlo. Ma credibile non vuol dire vero. Quando l'immagine di partenza non contiene abbastanza informazione, la rete riempie il vuoto con ciò che di solito contengono immagini simili: una pelle plausibile, un tessuto plausibile, foglie plausibili.
Cosa significano i modelli "2x" e "4x"
Una rete di super-risoluzione di solito viene addestrata per un fattore fisso. Un modello 4x restituisce sempre quattro volte larghezza e altezza dell'input; un modello 2x, il doppio. Per ottenere un'altra dimensione, gli strumenti usano il modello più vicino e poi ridimensionano il risultato. Per questo il nostro upscaler offre esattamente 2x e 4x: ciascuna opzione corrisponde a un passaggio di un modello adatto (ESRGAN-slim 2x o 4x), e ogni piccola correzione per arrivare a una dimensione esatta è un normale ridimensionamento successivo.
Per lo stesso motivo, ripassare un risultato 4x in un modello 4x raramente aiuta. Il secondo passaggio tratta la texture inventata dal primo come input reale e ne inventa altra sopra.
Far girare una rete neurale nel browser
Gli upscaler su server eseguono i modelli su schede grafiche dedicate. Un upscaler nel browser deve funzionare sul computer che ha il visitatore, attraverso gli standard del web. Il nostro si basa su tre elementi:
- Il modello: ESRGAN-slim, una versione compatta di ESRGAN distribuita con la libreria UpscalerJS, abbastanza piccola da essere scaricata una volta e tenuta nella cache del browser.
- Il motore: TensorFlow.js, che esegue i calcoli della rete sulla scheda grafica tramite WebGL.
- I tasselli: l'immagine viene tagliata in pezzi da 128 × 128 pixel che si sovrappongono di qualche pixel, ogni pezzo viene ingrandito separatamente e i risultati vengono ricuciti. Così l'uso della memoria grafica resta abbastanza basso per un portatile normale, e la sovrapposizione evita cuciture visibili.
I tasselli spiegano perché il tempo di elaborazione cresce con la dimensione dell'immagine di partenza e non con il fattore. Nei nostri test un'immagine da 480 pixel ha richiesto da 3 a 6 secondi a 4x una volta caricato il modello, mentre una foto da 1,7 megapixel circa 20 secondi a 2x. Il primo passaggio di ogni sessione è più lento perché il modello va scaricato e "scaldato".
Il browser impone limiti che un'app desktop non ha. I browser mobili non danno alle pagine web abbastanza memoria grafica per il modello, quindi su smartphone e tablet il nostro strumento usa un motore classico (un ridimensionamento di alta qualità per gradi più i cursori di miglioramento). Sui computer, l'IA gestisce immagini fino a circa 10 megapixel, e lo strumento è pensato per risultati fino al 4K, una dimensione che i browser gestiscono senza problemi sui computer comuni.
Misurare la differenza
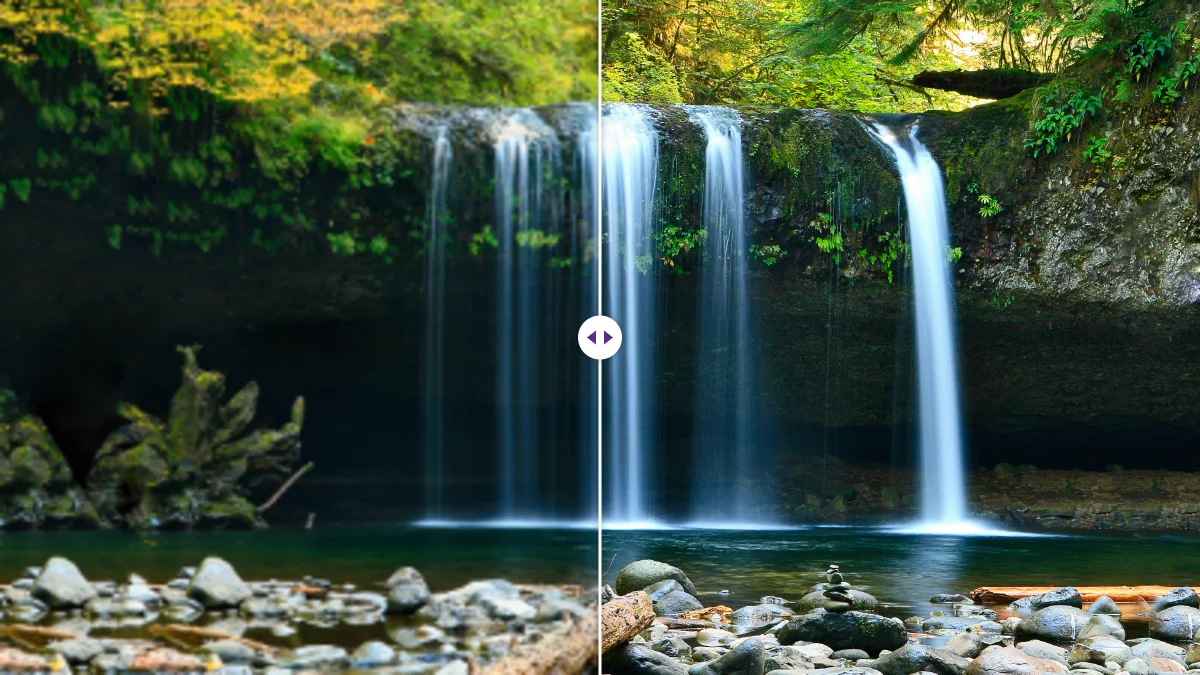
Dire "più nitido" è facile. Noi l'abbiamo misurato. Abbiamo preso un ritratto, l'abbiamo ridotto a 480 × 480 pixel per simulare una vecchia foto a bassa risoluzione e l'abbiamo ingrandito 4x a 1920 × 1920 in due modi: con il ridimensionamento di alta qualità del browser stesso e con il modello di IA. Poi abbiamo misurato il dettaglio dei contorni nello stesso ritaglio 480 × 480 del volto in entrambe le versioni, usando la varianza del laplaciano (una misura standard di quanto contrasto fine sui bordi ha un'immagine).
Il ridimensionamento normale ha ottenuto 3,0. Il risultato AI ha ottenuto 34,7, circa undici volte più dettaglio sui contorni. Guardare le immagini spiega il numero: le ciglia erano di nuovo peli separati, i bordi dei denti erano puliti e l'attaccatura dei capelli aveva una texture invece di una macchia morbida. Si vedeva anche la stranezza: la pelle era più liscia che in una vera foto ad alta risoluzione, un po' come dopo un leggero ritocco.
Una nota sulla misura. Gli articoli scientifici riportano spesso il PSNR, un numero che premia la vicinanza all'originale pixel per pixel. I modelli addestrati con un discriminatore di solito ottengono un PSNR un po' più basso dei modelli più lisci, pur sembrando migliori alle persone, perché una texture realistica leggermente fuori posto costa più punti di una sfocatura prudente. Per questo abbiamo guardato il dettaglio dei contorni e le immagini stesse, non un singolo numero di riferimento.
Perché i risultati cambiano così tanto da foto a foto
- I contenuti che il modello conosce bene (volti, capelli, testo, oggetti comuni, texture naturali) vengono meglio.
- I danni da compressione lo confondono: anche i blocchi del JPEG sono "dettaglio" e possono essere ingranditi come tale. Partire dalla copia più pulita conta più di qualsiasi impostazione.
- La sfocatura non è mancanza di risoluzione, ma mancanza di informazione. Una foto sfocata ingrandita è una foto sfocata più grande.
- I soggetti minuscoli danno al modello troppo poco materiale, quindi ciò che produce è soprattutto una sua ipotesi.
- La trasparenza richiede un trattamento speciale, perché il modello vede solo il colore. Durante i test abbiamo scoperto che il nostro upscaler rendeva neri gli sfondi trasparenti; ora riempie la zona vuota con i colori di bordo più vicini prima di ingrandire e poi ripristina la trasparenza originale.
Perché inganna l'occhio
Un'ultima osservazione sul perché tutto questo funziona. I nostri occhi giudicano la nitidezza soprattutto dai bordi: i confini tra chiaro e scuro. Un'immagine con bordi netti e texture semplificata appare nitida; una con texture accurata e bordi morbidi appare sfocata. I modelli di super-risoluzione sfruttano questo fatto. Concentrano lo sforzo dove guardiamo, ed è per questo che un risultato AI può sembrare più nitido di quanto giustifichi a rigore l'informazione che contiene.
Metterlo in pratica
Sapere come funziona porta ad alcune abitudini pratiche. Dai al modello l'originale più pulito e più grande disponibile. Scegli il fattore che arriva alla dimensione che ti serve, perché ogni raddoppio in più è più invenzione, non più verità. Lascia la nitidezza a zero all'inizio, perché il modello ricostruisce già i bordi. Controlla i risultati al 100% nei punti che contano. E salva le foto in JPG o WebP; nei nostri test un risultato a 2x pesava 6,85 MB in PNG e 337 KB in WebP, senza differenze visibili.
Per lavori specifici, le guide vanno oltre: come aumentare la risoluzione di un'immagine per la stampa, come ingrandire un'immagine in 4K per gli schermi, e le differenze tra ingrandire e migliorare. Se vuoi provarlo, l'upscaler di immagini funziona interamente nel tuo browser; la tua foto non viene caricata da nessuna parte.
Domande frequenti
Perché un ridimensionamento normale sfoca le immagini?
L'interpolazione stima ogni nuovo pixel dai vicini, quindi un bordo netto diventa una rampa morbida tra due valori. L'informazione per disegnare il bordo netto non si trova nei pixel vicini.
L'ingrandimento con IA è dettaglio reale?
È una stima appresa. Bordi e forme vengono ricostruiti in modo convincente, mentre la texture fine e casuale, come pori o ghiaia, viene inventata per sembrare plausibile, non recuperata.
Perché l'upscaler nel browser lavora a tasselli?
Elabora l'immagine in pezzi da 128 × 128 pixel che si sovrappongono un po', così un portatile normale ha abbastanza memoria grafica; la sovrapposizione evita cuciture visibili.
Continua a leggere
Strumenti per immagini gratuiti, nel tuo browser
Ingrandisci, rimuovi lo sfondo, elimina i metadati, ritaglia, comprimi o crea un codice QR. Nessun caricamento, nessuna registrazione, nessuna filigrana.